راهنما
اتصال به مدل
پارسرگ پاسخ را با مدلی مینویسد که خودتان انتخاب میکنید. همین انتخاب مشخص میکند پاسخ کجا تولید شود و چه چیزی از رایانهٔ شما بیرون برود. خواندن فایلها، OCR و جستوجو در هر حالت محلی میماند.
| ارائهدهنده | پاسخ کجا نوشته میشود | چه چیزی از پارسرگ بیرون میرود |
|---|---|---|
| مدل محلی با Ollama | همین رایانه | هیچچیز، از مسیر آداپتور مدل |
| سرویس API خصوصی | سروری که در اختیار خودتان است | پرسش شما و بخشهای بازیابیشده |
| سرویس API خارجی | سرویس یک شخص ثالث | پرسش شما و بخشهای بازیابیشده |
تنظیمات «مدل و اتصال»
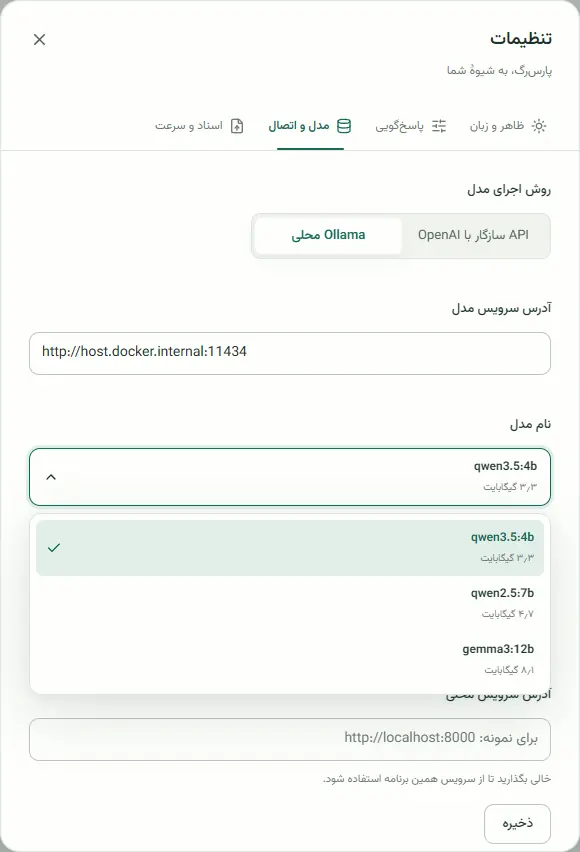
- روش اجرای مدل: «API سازگار با OpenAI» یا «Ollama محلی». تغییر از پرسش بعدی و بدون راهاندازی دوباره اعمال میشود.
- در حالت Ollama، نشانی پیشفرض http://host.docker.internal:11434 است و «یافتن مدلهای نصبشده» مدلهای نصبشده را همراه با حجمشان در یک فهرست نشان میدهد.
- کلید API فقط در حافظهٔ سرویس نگه داشته میشود، نه در مرورگر و نه در فایل تنظیمات. پس از هر راهاندازی مجدد، باید آن را از نو وارد کنید یا در یک متغیر محیطی قرار دهید.
- مرز حریم خصوصی API: پیش از استفاده از API خارجی، تأیید میکنید که پرسش شما و بخشهای مرتبط اسناد برای آن فرستاده میشود.
- پیش از ذخیرهٔ تنظیمات غیرمحرمانه، اتصال آزمایش میشود. اگر Ollama خطا بدهد، تنظیمات علتش را میگوید (نشانی مجاز نیست یا Ollama پاسخ نداد) و اگر API فعال باشد، نشانی Ollamaی خود سرور را پیشنهاد میکند.
- بخش «تنظیمات پیشرفتهٔ مدل» اندازهٔ زمینه، «فکر کردن» مدل، تلاش دوباره و مهلتها را در خود دارد.
قواعد ایمنی برای نشانی سرویسها
- نشانیهای عمومی API باید HTTPS باشند. استفاده از HTTP فقط برای نشانیهای loopback و شبکهٔ خصوصی مجاز است.
- نشانیهای link-local، multicast و رزروشده پذیرفته نمیشوند.
- نشانی Ollama باید ساده و به شکل http://host:port باشد، روی localhost، 127.0.0.1، ::1، ollama، host.docker.internal یا میزبانی که در OLLAMA_ALLOWED_HOSTS نوشتهاید، مثلاً یک سرور GPU در شبکهٔ محلی. نام کاربری، مسیر، پارامتر و HTTPS پذیرفته نمیشوند.
- سرویسهای خصوصی سازگار با OpenAI میتوانند بدون کلید هم کار کنند.
مدلهای فکرکننده و رفتارهای خاص API
- پارسرگ از Ollama میخواهد پیش از پاسخ «فکر» نکند (OLLAMA_THINK=0). وگرنه مدلهایی مثل qwen3، qwen3.5 یا deepseek-r1 ممکن است کل بودجهٔ پاسخ را صرف استدلال کنند و پاسخ خالی برگردانند. مقدار OLLAMA_THINK=1 را فقط همراه با OLLAMA_CONTEXT_LENGTH بزرگتر به کار ببرید.
- استدلالی که بعضی APIها داخل پاسخ میگذارند (بلوکهای <thought> یا <think>) از پاسخ، متن جریانی، عنوان گفتوگو و پرسشهای پیشنهادی حذف میشود.
- خطاهای موقت API (HTTP 5xx و 429) با فاصلههایی که کمکم بیشتر میشوند، حداکثر به تعداد MODEL_API_MAX_RETRIES دوباره امتحان میشوند.
- سرویس Google AI Studio از راه نشانی سازگار با OpenAI کار میکند و پیشوند models/ که لازم دارد خودکار اضافه میشود. اگر اعتبار حساب سرویسدهنده تمام شده باشد (HTTP 402)، پیام خطا همین را میگوید.
- مدل در .env.example
- مدل qwen2.5:7b روی Ollamaی نصبشده روی رایانه
- نشانی پیشفرض API
- https://openrouter.ai/api/v1
- مهلت پاسخ
- بهطور پیشفرض ۱۲۰ ثانیه؛ اگر مهلت درخواست API تمام شود، یک بار دیگر فرستاده میشود
- تلاش دوباره برای API
- بهطور پیشفرض ۴ بار، برای خطاهای HTTP 5xx و 429
- پنجرهٔ زمینه
- ۸٬۱۹۲ توکن برای Ollama و ۳۲٬۷۶۸ توکن برای API؛ هر دو قابل تنظیماند