مربوط به پارسرگ ۱.۱.۲۲ آبان ۱۴۰۵
پارسرگ از درون
هر کاری که نسخهٔ فعلی انجام میدهد، از نصب تا خواندن پاسخی که به منبعش ارجاع میدهد. هر فصل از روی کد و اسناد همان نسخهای نوشته شده که نامش پایینتر آمده است.
پارسرگ چیست
پارسرگ فضای کاری دوزبانه و آفلاینمحور برای پرسش از اسناد فارسی و انگلیسی است. فایلهای PDF، Word و PowerPoint، اسکنها، تصویرها، متن و کد را میخواند و هر پاسخ نشان میدهد مطلب از کدام فایل و کدام جای آن آمده است.
باز کردن در صفحهٔ جدااز اسنادتان بپرسید
فایلها را به یک گفتوگو اضافه کنید و به فارسی یا انگلیسی بپرسید. اگر با @ به یک فایل اشاره کنید، جستوجو فقط در همان فایل انجام میشود.
هر پاسخ را بررسی کنید
پاسخها ارجاع شمارهدار دارند و هر ارجاع همان متن را با صفحه، اسلاید، بند، جدول یا تصویرش باز میکند. اگر متنی از یک تصویر خوانده شده باشد، خود تصویر هم کنارش دیده میشود.
محلی از پایه
خواندن فایلها، OCR، ایندکس جستوجو و تاریخچهٔ گفتوگو روی رایانهٔ خودتان میماند. جای نوشتهشدن پاسخ را هم خودتان انتخاب میکنید.
فارسی در اولویت
رابط راستبهچپ، OCR فارسی، یکسانسازی املای فارسی و خواندن PDF فارسی به ترتیب درست، همه جزو خود برنامهاند.
این نسخه در یک نگاه
- نسخه
- ۱.۱.۲، منتشرشده در ۲ آبان ۱۴۰۵
- مجوز
- کد منبع در دسترس، اما نه متنباز
- سیستمعامل
- ویندوز، مک و لینوکس با Docker Compose؛ اجرای مستقیم با Python 3.12 و Node.js 22
- بکاند
- Python، FastAPI، LlamaIndex، Qdrant، sentence-transformers، PyMuPDF و Tesseract OCR
- فرانتاند
- React 19، TypeScript 7، Vite و KaTeX
- راهاندازی پیشنهادی مدل
- همان Ollamaی که روی رایانهتان نصب است، با مدلها و GPU خودش؛ در .env.example مدل qwen2.5:7b آمده است
- تنظیمات
- ۲۷ گزینه بدون راهاندازی دوباره در خود برنامه تغییر میکنند و هرکدام را میتوان به مقدار .env برگرداند
نصب و نخستین اجرا
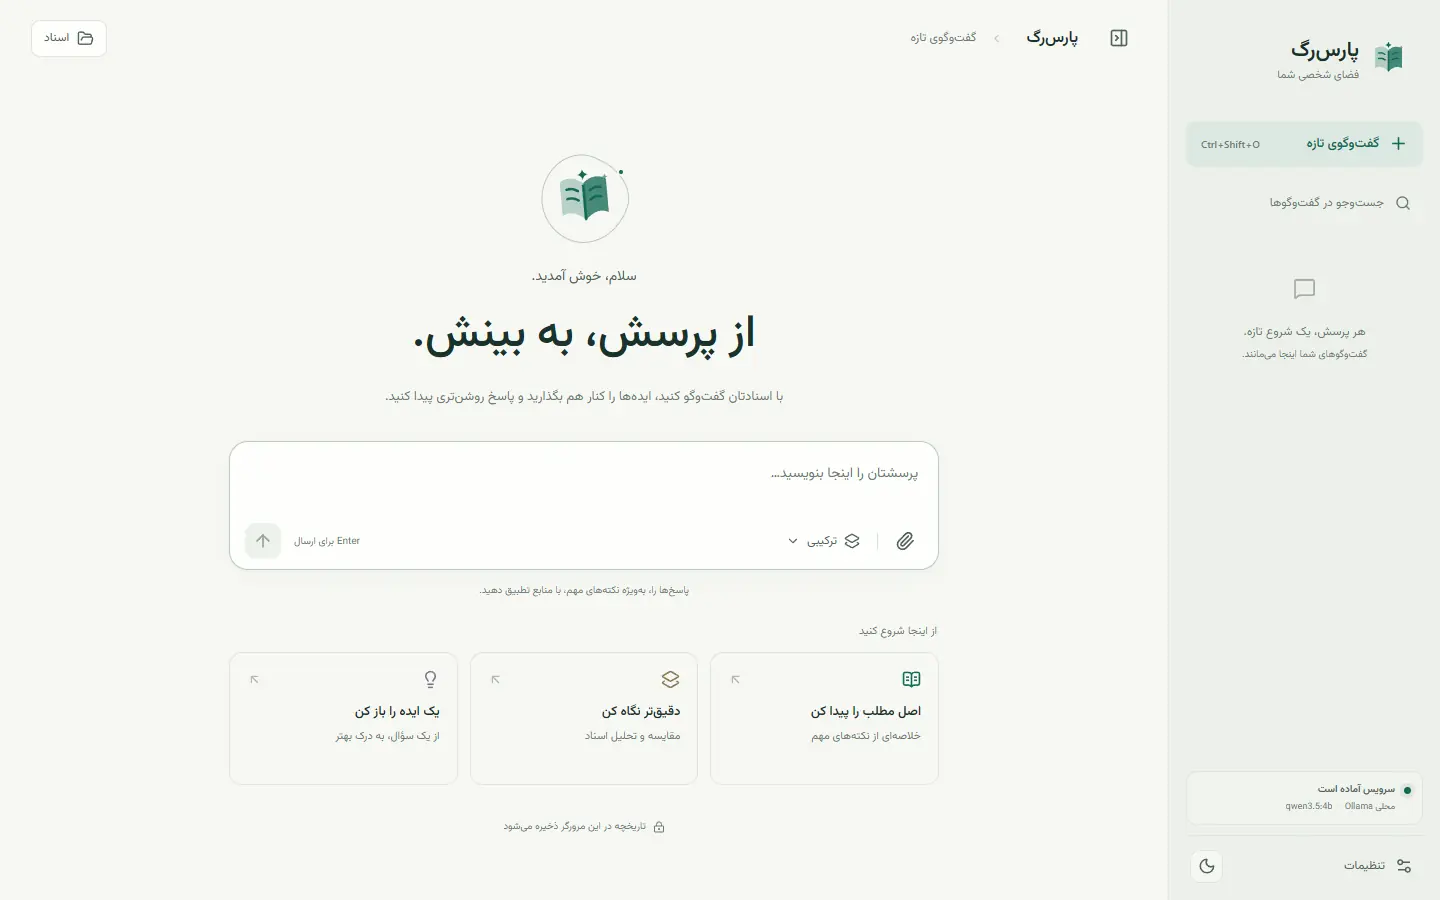
روش پیشنهادی برای اجرای پارسرگ، Docker Compose همراه با Ollamaی است که از قبل روی رایانهتان نصب است: یک کانتینر برنامه رابط کاربری و API را ارائه میکند، Qdrant بردارها را نگه میدارد و پاسخها را Ollamaی خودتان مینویسد. اجرای Ollama داخل Docker و استفاده از مدلهای API، راههای دیگر اجرا هستند.
باز کردن در صفحهٔ جداپیشنیازها
راهاندازی کامل
در راهاندازی پیشنهادی، پاسخها را همان Ollamaی مینویسد که روی رایانهتان نصب است، با مدلهایی که از قبل دارید و روی GPU خودش. برنامه از راه نشانی host.docker.internal به آن وصل میشود؛ پس نه پروفایل Compose لازم است و نه فایل override، و کانتینر برنامه هم به GPU نیازی ندارد. روی مک تنها راه تولید پاسخ با GPU همین است، چون Docker نمیتواند GPU مک را در اختیار کانتینر بگذارد.
- برنامهٔ Ollama را نصب کنید و یک مدل بگیرید. روی GPU حدود ۶ گیگابایتی، مدل ۳ تا ۴ میلیارد پارامتری کاملاً روی GPU اجرا میشود.
- فایل .env.example را با نام .env کپی کنید و در LLM_MODEL_NAME نام مدلی را بنویسید که گرفتهاید. پیشفرضهای این فایل از قبل برنامه را به Ollamaی همین رایانه وصل میکنند: OLLAMA_DOCKER_BASE_URL=http://host.docker.internal:11434.
- فقط در لینوکس: Ollama بهطور پیشفرض فقط روی 127.0.0.1 گوش میدهد و کانتینرها به آن نمیرسند. سرویس Ollama را روی نشانی پل Docker تنظیم کنید، مثلاً OLLAMA_HOST=172.17.0.1:11434. ویندوز و مک کاری لازم ندارند.
- پارسرگ را اجرا کنید، نشانی http://127.0.0.1:8000 (یا پورتی که در PARSRAG_PORT گذاشتهاید) را باز کنید، سند بارگذاری کنید و بپرسید.
ollama pull qwen2.5:7b
Copy-Item .env.example .env
docker compose up -d --build
ollama ps
در مک یا لینوکس، فایل تنظیمات را با cp .env.example .env کپی کنید. وقتی پاسخ در حال نوشتهشدن است، دستور ollama ps نشان میدهد مدل کجا اجرا میشود؛ عبارت 100% GPU یعنی کل مدل روی GPU است. پورت فقط روی نشانی 127.0.0.1 در دسترس است، مگر اینکه PARSRAG_BIND_HOST را تغییر دهید.
برنامهٔ Ollama احراز هویت ندارد. در لینوکس نشانی پل را ترجیح دهید: مقدار OLLAMA_HOST=0.0.0.0 درگاه Ollama را روی همهٔ شبکههایی که رایانه به آنها وصل است باز میکند. اگر از آن استفاده میکنید، درگاه 11434 را فقط برای شبکههای Docker باز بگذارید.
روشهای دیگر اجرا
| نوع نصب | مناسب برای | روش |
|---|---|---|
| اجرای Ollama داخل Docker روی CPU | وقتی Ollama روی رایانه نصب نیست؛ روی هر سیستمی اجرا میشود | پروفایل local-model، همراه با OLLAMA_DOCKER_BASE_URL=http://ollama:11434 و OLLAMA_MODEL در فایل .env |
| کارت NVIDIA | اجرای Ollama داخل Docker با ساخت embedding و تولید پاسخ سریعتر در ویندوز یا لینوکس | افزودن فایل compose.gpu.yaml |
| کارت NVIDIA با VRAM کم | کارتهای حدود ۶ گیگابایتی که جای هر دو مدل را ندارند | افزودن فایل compose.gpu-low-vram.yaml: embedding روی CPU و پنجرهٔ زمینهٔ Ollama برابر ۲۰۴۸ |
| کارت AMD | میزبانهای لینوکسی پشتیبانیشده با ROCm | افزودن فایل compose.amd.yaml (با PyTorch 2.6 و wheelهای ROCm) |
| مدل از راه API | وقتی سختافزار محلی مناسبی ندارید | تنظیم LLM_PROVIDER=api و نشانی سرویس در فایل .env، یا انتخاب آن در تنظیمات برنامه |
docker compose --profile local-model up -d qdrant ollama
docker compose --profile local-model run --rm ollama-init
docker compose --profile local-model up -d --build app
نخستین اجرا
- مدل تبدیل متن به بردار (intfloat/multilingual-e5-base) و رتبهبند حالت ترکیبی (حدود ۱۰۰ مگابایت) در کش مدلها دانلود میشوند.
- با Ollamaی خود رایانه، پارسرگ هیچ مدلی دانلود نمیکند. با Ollama داخل Docker، سرویس ollama-init مدل تنظیمشده را فقط یک بار، در volume مخصوص خودش، دانلود میکند.
- تا وقتی همهچیز آماده نشده، نشانی /health/ready با کد 503 و وضعیت preparing پاسخ میدهد و رابط هم نشان میدهد که مدل و پایگاه اسناد در حال آمادهشدناند.
- اگر هنگام شروع برنامه Ollama خاموش باشد، برنامه باز هم آماده میشود. تا Ollama روشن نشود، پرسشها پیام میگیرند که سرویس مدل در دسترس نیست و بعد بدون راهاندازی دوباره کار میکنند.
- پس از نخستین دانلودها، نصبی که با Ollama محلی کار میکند میتواند آفلاین اجرا شود.
اجرا بدون Docker
برای اجرای مستقیم به Python 3.12، Node.js 22، یک Qdrant در حال اجرا، Ollama یا یک سرویس سازگار با OpenAI، و برای OCR به Tesseract با دادههای فارسی و انگلیسی نیاز دارید. فایل .env.example را با نام .env کپی کنید و علامت # را از سطرهای بخش «Running without Docker» در انتهای آن بردارید: نشانی Qdrant، نشانی Ollama، فایل تنظیمات و OCR_ENABLED=1.
py -3.12 -m venv .venv
.\.venv\Scripts\python.exe -m pip install -r requirements-runtime.txt -c requirements.lock
Set-Location frontend
npm ci
npm run build
Set-Location ..
.\.venv\Scripts\python.exe -m uvicorn backend.main:app --host 127.0.0.1 --port 8000
در اجرای مستقیم، تا وقتی OCR_ENABLED=1 را تنظیم نکنید OCR خاموش میماند. در نصب با Docker، OCR روشن است.
دستورهای روزمره
docker compose ps
docker compose logs -f app
docker compose down
دستور docker compose down دادهها را نگه میدارد. اما docker compose down -v بردارها، تنظیماتی که در برنامه ذخیره کردهاید، کشها و وزن مدلهای Ollama داخل Docker را برای همیشه پاک میکند.
اتصال به مدل
پارسرگ پاسخ را با مدلی مینویسد که خودتان انتخاب میکنید. همین انتخاب مشخص میکند پاسخ کجا تولید شود و چه چیزی از رایانهٔ شما بیرون برود. خواندن فایلها، OCR و جستوجو در هر حالت محلی میماند.
باز کردن در صفحهٔ جدا| ارائهدهنده | پاسخ کجا نوشته میشود | چه چیزی از پارسرگ بیرون میرود |
|---|---|---|
| مدل محلی با Ollama | همین رایانه | هیچچیز، از مسیر آداپتور مدل |
| سرویس API خصوصی | سروری که در اختیار خودتان است | پرسش شما و بخشهای بازیابیشده |
| سرویس API خارجی | سرویس یک شخص ثالث | پرسش شما و بخشهای بازیابیشده |
تنظیمات «مدل و اتصال»
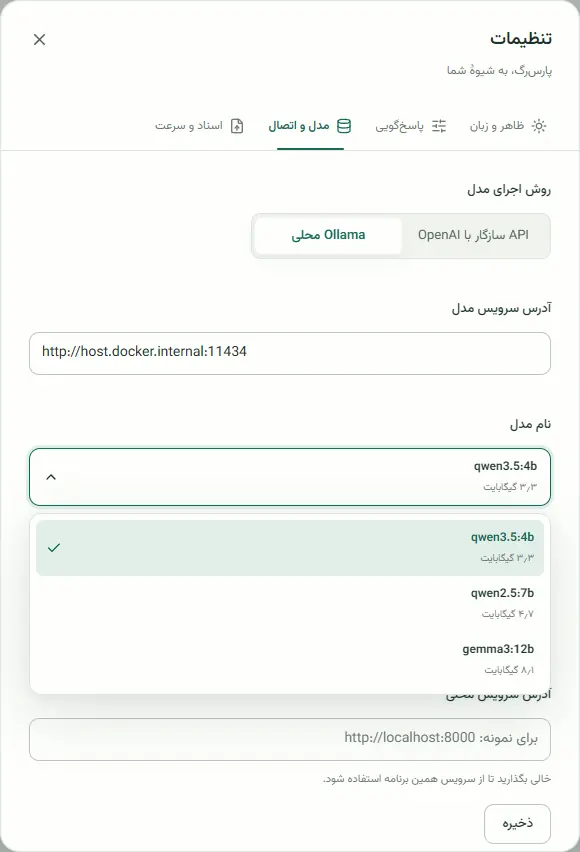
- روش اجرای مدل: «API سازگار با OpenAI» یا «Ollama محلی». تغییر از پرسش بعدی و بدون راهاندازی دوباره اعمال میشود.
- در حالت Ollama، نشانی پیشفرض http://host.docker.internal:11434 است و «یافتن مدلهای نصبشده» مدلهای نصبشده را همراه با حجمشان در یک فهرست نشان میدهد.
- کلید API فقط در حافظهٔ سرویس نگه داشته میشود، نه در مرورگر و نه در فایل تنظیمات. پس از هر راهاندازی مجدد، باید آن را از نو وارد کنید یا در یک متغیر محیطی قرار دهید.
- مرز حریم خصوصی API: پیش از استفاده از API خارجی، تأیید میکنید که پرسش شما و بخشهای مرتبط اسناد برای آن فرستاده میشود.
- پیش از ذخیرهٔ تنظیمات غیرمحرمانه، اتصال آزمایش میشود. اگر Ollama خطا بدهد، تنظیمات علتش را میگوید (نشانی مجاز نیست یا Ollama پاسخ نداد) و اگر API فعال باشد، نشانی Ollamaی خود سرور را پیشنهاد میکند.
- بخش «تنظیمات پیشرفتهٔ مدل» اندازهٔ زمینه، «فکر کردن» مدل، تلاش دوباره و مهلتها را در خود دارد.
قواعد ایمنی برای نشانی سرویسها
- نشانیهای عمومی API باید HTTPS باشند. استفاده از HTTP فقط برای نشانیهای loopback و شبکهٔ خصوصی مجاز است.
- نشانیهای link-local، multicast و رزروشده پذیرفته نمیشوند.
- نشانی Ollama باید ساده و به شکل http://host:port باشد، روی localhost، 127.0.0.1، ::1، ollama، host.docker.internal یا میزبانی که در OLLAMA_ALLOWED_HOSTS نوشتهاید، مثلاً یک سرور GPU در شبکهٔ محلی. نام کاربری، مسیر، پارامتر و HTTPS پذیرفته نمیشوند.
- سرویسهای خصوصی سازگار با OpenAI میتوانند بدون کلید هم کار کنند.
مدلهای فکرکننده و رفتارهای خاص API
- پارسرگ از Ollama میخواهد پیش از پاسخ «فکر» نکند (OLLAMA_THINK=0). وگرنه مدلهایی مثل qwen3، qwen3.5 یا deepseek-r1 ممکن است کل بودجهٔ پاسخ را صرف استدلال کنند و پاسخ خالی برگردانند. مقدار OLLAMA_THINK=1 را فقط همراه با OLLAMA_CONTEXT_LENGTH بزرگتر به کار ببرید.
- استدلالی که بعضی APIها داخل پاسخ میگذارند (بلوکهای <thought> یا <think>) از پاسخ، متن جریانی، عنوان گفتوگو و پرسشهای پیشنهادی حذف میشود.
- خطاهای موقت API (HTTP 5xx و 429) با فاصلههایی که کمکم بیشتر میشوند، حداکثر به تعداد MODEL_API_MAX_RETRIES دوباره امتحان میشوند.
- سرویس Google AI Studio از راه نشانی سازگار با OpenAI کار میکند و پیشوند models/ که لازم دارد خودکار اضافه میشود. اگر اعتبار حساب سرویسدهنده تمام شده باشد (HTTP 402)، پیام خطا همین را میگوید.
- مدل در .env.example
- مدل qwen2.5:7b روی Ollamaی نصبشده روی رایانه
- نشانی پیشفرض API
- https://openrouter.ai/api/v1
- مهلت پاسخ
- بهطور پیشفرض ۱۲۰ ثانیه؛ اگر مهلت درخواست API تمام شود، یک بار دیگر فرستاده میشود
- تلاش دوباره برای API
- بهطور پیشفرض ۴ بار، برای خطاهای HTTP 5xx و 429
- پنجرهٔ زمینه
- ۸٬۱۹۲ توکن برای Ollama و ۳۲٬۷۶۸ توکن برای API؛ هر دو قابل تنظیماند
افزودن اسناد
هر گفتوگو اسناد خودش را دارد. اسناد را در پنل «اسناد» اضافه میکنید، مشخص میکنید پاسخها از کدامها استفاده کنند و میتوانید فایلی را که در گفتوگوی دیگری ایندکس شده، به این گفتوگو بیاورید.
باز کردن در صفحهٔ جدابارگذاری
- فایلها را بکشید و رها کنید یا انتخاب کنید. برای هر فایل سه مرحله نمایش داده میشود: «انتقال فایل»، «استخراج و ایندکس» و «آمادهٔ پرسش»؛ بعد هم تعداد بخشهای ایندکسشده.
- ظرفیت پیشفرض: ۱۰ فایل در هر گفتوگو، هر فایل تا ۱۰۰ مبیبایت و هر بارگذاری تا ۵۰۰ مبیبایت. رابط، محدودیتهای واقعی را از خود سرویس میگیرد و میتوانید آنها را در «تنظیمات ← اسناد و سرعت» تغییر دهید.
- بارگذاری گروهی یا کامل انجام میشود یا اصلاً انجام نمیشود. اگر یکی از فایلها خطا بدهد، هیچچیز از آن درخواست نیمهایندکسشده باقی نمیماند.
فایلهای پشتیبانیشده
| نوع | پسوندها | شیوهٔ خواندن |
|---|---|---|
| اسناد | .pdf .docx .pptx | استخراج ساختاریافتهٔ متن؛ OCR برای صفحههای اسکنشده یا پرتصویر PDF و تصویرهای جاسازیشده |
| تصویرها | .png .jpg .jpeg .webp .bmp .tif .tiff | اعتبارسنجی و خواندن با OCR |
| متن و داده | .txt .md .markdown .json .csv .tsv .log | کدگذاری UTF-8، UTF-16 با BOM، Windows-1256 (فارسی) یا Windows-1252؛ فایل JSON اعتبارسنجی میشود |
| نشانهگذاری و پیکربندی | .html .htm .xml .yaml .yml .toml .ini .cfg | متن قابلمشاهده از فایلهای نشانهگذاری؛ متن ساده از فایلهای پیکربندی |
| کد منبع | .py .js .jsx .ts .tsx .css .sql | متن همراه با فرادادهٔ قسمتها |
بررسیهای پیش از خواندن
- نام فایل باید یک نام سادهٔ حداکثر ۲۵۵ نویسهای و بدون مسیر باشد.
- فایل PDF باید واقعاً PDF باشد و فایل Word یا PowerPoint یک آرشیو واقعی Office. اگر فایلی رمز داشته باشد، پیام خطا همین را میگوید.
- سقف آرشیوهای Office: ۱۰٬۰۰۰ ورودی، ۲۰۰ مبیبایت حجم بازشده و نسبت فشردهسازی ۲۰۰ برای هر ورودی.
- اگر محتوای فایلی با سندی که در گفتوگو هست یکی باشد، شناسایی میشود و دو بار اضافه نمیشود.
وقتی فقط بخشی از فایل خوانده میشود
| اعلان | معنا |
|---|---|
| سقف OCR | فقط صفحههای اسکنشدهٔ ابتدای فایل خوانده شد (سقف پیشفرض ۳۰ صفحه است). |
| سقف تصویر OCR | بعضی از تصویرهای درون فایل Word یا PowerPoint خوانده نشد (سقف پیشفرض ۲۰۰ تصویر است). |
| خوانش ناقص OCR | بعضی از صفحهها یا تصویرها با OCR خوانده نشد. |
| در دسترس نبودن OCR | ابزار Tesseract نصب نیست، ولی صفحههای متنی ایندکس شدند. |
مدیریت اسناد
- گزینهٔ «استفاده در پاسخ»: هر سند را علامت بزنید یا علامتش را بردارید. برداشتن علامت همهٔ اسناد هم ممکن است.
- بخش «از گفتوگوهای قبلی»: سندی را که قبلاً ایندکس شده، بدون بارگذاری دوباره اضافه کنید. وقتی کپی تمام شد، این نسخه از نسخهٔ اصلی مستقل است.
- حذف سند با تأیید دومرحلهای انجام میشود و بخشها و تصویرهای نگهداشتهشدهٔ آن از ایندکس پاک میشوند.
اسنادی که با نسخهٔ 1.0.0 ایندکس شدهاند همچنان کار میکنند. فایلهای Word و PowerPoint را دوباره بارگذاری کنید تا ارجاع به تصویر و جدول، نمایش تصویر کنار منبع، خواندن تصویرهای بعد از سیامین و OCR بهتر اسکرینشاتها را داشته باشید.
اسناد چطور خوانده میشوند
پیش از آنکه بتوان به چیزی ارجاع داد، پارسرگ هر فایل را به بخشهایی تبدیل میکند که جایشان مشخص است: متن، همراه با نام فایل و صفحه، اسلاید، بند، جدول یا تصویری که از آن آمده.
باز کردن در صفحهٔ جدافایلهای PDF
- هر صفحه قسمتی جداگانه است تا ارجاع بتواند شمارهٔ صفحه را بیاورد.
- صفحههای فارسی از روی جای هر حرف، به ترتیب خواندن بازسازی میشوند: سطرهای راستبهچپ، متن لاتین و ارقام داخل سطر، پرانتزهای قرینه و نشانهٔ اضافه روی حرف خودش.
- صفحهای به OCR فرستاده میشود که متن نداشته باشد، لایهٔ متنیاش بههمریخته باشد، یا کمتر از ۴۰ نویسه متن و دستکم یک تصویر داشته باشد.
نویسهخوانی (OCR)
- ابزار Tesseract با دادههای فارسی و انگلیسی، روی صفحههایی که با ۲۰۰ dpi و بهصورت خاکستری رندر شدهاند، بدون کشش کنتراست.
- اگر خوانش اول ضعیف باشد (میانگین اطمینان زیر ۷۵)، یک دور دوم بهصورت تکبلوکی اجرا میشود و از دو خوانش، آنکه اطمینان بیشتری دارد انتخاب میشود.
- صفحههایی که ۹۰، ۱۸۰ یا ۲۷۰ درجه چرخیدهاند و صفحههایی که ۲ درجه یا بیشتر کجاند، شناسایی و دوباره خوانده میشوند.
- تصویرها و اسکرینشاتها یک دور دیگر هم خوانده میشوند، روی نسخهٔ بزرگشده و سیاهوسفید تصویر و با حالتی که متن پراکنده را پیدا میکند. این دور متنهایی را اضافه میکند که تحلیل چیدمان صفحه جا انداخته، مثل پنلهای وضعیت، نوارابزارهای تیره و متن روی پنلهای رنگی.
- تصویرهای درون Word و PowerPoint چندتا با هم خوانده میشوند (OCR_WORKERS؛ پیشفرض: همهٔ هستههای CPU، حداکثر ۸) و متن حاصل با خواندن تکبهتک فرقی ندارد.
- محدودیتهای پیشفرض: ۳۰ صفحهٔ اسکنشده در هر PDF و ۲۰۰ تصویر در هر فایل Word یا PowerPoint، ۴۵ ثانیه برای هر صفحه و ۴۰ میلیون پیکسل برای هر تصویر. تصویرهای کوچکتر از ۱۰٬۰۰۰ پیکسل، مثل آیکونها، خوانده نمیشوند.
فایلهای Word، PowerPoint و دیگر قالبها
- فایل Word: بندها زیر سرعنوان خودشان و تا سقف ۱۸۰ واژه گروهبندی میشوند و هر بخش مسیر سرعنوانهایش را با خود دارد. دستورها و کدهایی که در کادرهای تکخانهای آمدهاند، کنار جملهای میمانند که معرفیشان میکند.
- جدولهای Word به جدول Markdown همراه با رکورد هر سطر تبدیل میشوند و با شمارهٔ جدول و بندی که پیش از آن آمده ارجاع میگیرند، مثلاً «بند ۱۲۰ · جدول ۳».
- تصویرهای درون Word و PowerPoint: متنی که از هر تصویر خوانده میشود، همراه با عنوان تصویر، بخش جداگانهای است و با «بند ۱۲۰ · تصویر ۷» یا «اسلاید ۲۵ · تصویر ۹» ارجاع میگیرد. این بخش متنی را هم که تصویر را معرفی میکند با خود دارد و پاسخ میگوید کدام مطلب از تصویر آمده است.
- فایل PowerPoint: برای هر اسلاید یک قسمت، همراه با جدولهایش.
- از فایلهای HTML و XML فقط متن قابلمشاهده نگه داشته میشود. فایل JSON اعتبارسنجی و به شکلی خواناتر بازنویسی میشود.
بخشها
- متن به بخشهایی حدود ۵۱۲ توکنی تقسیم میشود که ۵۰ توکن با هم همپوشانی دارند. بخشهای هر سند به ترتیب طول، دستهدسته به بردار تبدیل میشوند.
- برای صفحههای پشتسرهم PDF، یک بخش اضافه ۹۰ واژهٔ آخر هر صفحه را به ۹۰ واژهٔ اول صفحهٔ بعد وصل میکند. به این ترتیب مطلبی که با عوضشدن صفحه دو تکه شده، با بازهٔ صفحهها ارجاع داده میشود.
- املای فارسی در بخشها و پرسشها یکسانسازی میشود: ی و ک عربی، شکلهای نمایشی حروف، اِعراب و ارقام. همزهٔ اضافه حفظ میشود.
- از هر تصویری که با OCR خوانده میشود، یک نسخهٔ WebP با عرض حداکثر ۱۲۸۰ پیکسل نگه داشته میشود تا منبع بتواند آن را نشان دهد.
یافتن شواهد
وقتی پرسشی مطرح میکنید، پارسرگ فقط در اسناد همین گفتوگو جستوجو میکند، هم بر اساس معنا و هم کلیدواژه، و بخشهایی را برمیدارد که به احتمال زیاد پاسخ را در خود دارند.
باز کردن در صفحهٔ جدادو نوع جستوجو
- جستوجوی معنایی: هر بخش یک بردار ۷۶۸بعدی از مدل intfloat/multilingual-e5-base دارد که با فاصلهٔ کسینوسی در Qdrant ذخیره میشود.
- جستوجوی کلیدواژهای: یک ایندکس BM25 روی همان بخشها (با k1 برابر ۱٫۲ و b برابر ۰٫۷۵) نامها، عددها و کدها را عیناً پیدا میکند.
- این دو رتبهبندی با روش reciprocal rank fusion و با k برابر ۶۰ ادغام میشوند.
- هر جستوجو به همین گفتوگو محدود است و اگر از @ استفاده کنید، به همان فایلی که نام بردهاید.
تعداد بخشها
- عمق جستوجو با نوع پرسش تغییر میکند و بین ۸ تا ۳۰ بخش است: برای خلاصه، مقایسه، فهرست و جدول بیشتر، و برای پرسشهای کوتاهی که یک واقعیت را میپرسند کمتر.
- وقتی چند فایل در کار است، پرسشهای کلی جستوجو را بین فایلها پخش میکنند تا یک سند بزرگ جای بقیه را نگیرد. پرسشهای مشخص در همهٔ فایلها با هم جستوجو میشوند تا فایلی که پاسخ در آن است بیشترِ بخشها را بدهد؛ هر فایل دیگر هم بهترین بخش خودش را میآورد و بخشی که در چند فایل تکرار شده، فقط یک بار میآید.
- در «تنظیمات ← پاسخگویی» میتوانید این تعداد را خودتان بین ۱ تا ۵۰ تعیین کنید، یا خالی بگذارید تا برای هر پرسش جداگانه انتخاب شود.
پرسشهای چندبخشی
- پرسشی که چند چیز را با هم میپرسد، مثل «با کدام کلید حالت ویرایش باز میشود و نمونه چه فیلدهایی اضافه کرد؟»، تکهبهتکه هم جستوجو میشود. هر تکه بهترین بخشهای خودش را نگه میدارد و از مدل خواسته میشود به همهٔ تکهها پاسخ دهد و بگوید اسناد به کدامیک نپرداختهاند.
- وقتی بخشی از یک جدول بازیابی شود، بقیهٔ جدول هم همراهش میآید تا پرسش دربارهٔ بیشترین یا کمترین مقدار، همهٔ سطرها را ببیند.
تفاوت شیوهها
| شیوه | بازیابی | دانش مدل | گام اضافه |
|---|---|---|---|
| فقط اسناد (Strict) | الزامی | کنار گذاشته میشود | دروازهٔ شواهد پیش از پاسخ |
| ترکیبی | الزامی، با رتبهبندی دوباره | میتواند پاسخ را کامل کند و جدا مشخص میشود | رتبهبند cross-encoder مخصوص خط عربی-فارسی |
| گفتوگوی آزاد | انجام نمیشود | مستقیم به کار میرود | ندارد |
دروازهٔ شواهد
حالت «فقط اسناد» تنها وقتی از پاسخدادن خودداری میکند که هر سه شرط برقرار باشد: امتیاز بهترین بخش کمتر از آستانه باشد (پیشفرض ۰٫۷۵ که در «تنظیمات ← پاسخگویی» تغییر میکند)، پرسش دربارهٔ کل سند نباشد و بخشها به اندازهٔ کافی واژههای شاخص پرسش را نداشته باشند. وقتی با @ به فایلها اشاره میکنید، هر فایل نامبرده باید شاهد خودش را داشته باشد.
این دروازه یک محافظ نرمافزاری است، نه تضمین. پاسخهای مهم را با منابعشان تطبیق دهید.
پرسیدن
کادر پیام جایی است که پرسش به جستوجو تبدیل میشود. در آن میتوانید شیوهٔ پاسخ را انتخاب کنید، به فایلها اشاره کنید یا از پرسشی شروع کنید که اسنادتان جوابش را دارند.
باز کردن در صفحهٔ جداکادر پیام
- کلید Enter پیام را میفرستد و Shift+Enter سطر تازه باز میکند. پیام میتواند تا ۳۰٬۰۰۰ نویسه باشد.
- با تایپ @ به یکی از اسناد ایندکسشده اشاره کنید. پرسش به چند تکه تقسیم میشود و هر تکه در فایل مربوط به خودش جستوجو میشود.
- بدون @، اگر نام فایلی را در پرسش بیاورید جستوجو به همان فایل محدود میشود؛ اما داشتن یک واژهٔ معمولی مشترک با نام فایل، مثل «اول» یا «تست»، دیگر این کار را نمیکند.
- با تایپ / در ابتدای سطر، دستورهای آماده باز میشوند.
- تا پاسخ در حال دریافت است، دکمهٔ ارسال به «توقف» تبدیل میشود و آنچه تا آن لحظه نوشته شده، حفظ میشود.
دستورهای آماده
| دستور | کاربرد |
|---|---|
| /summary | خلاصهٔ اسناد انتخابشده، با ذکر منبع |
| /compare | مقایسهٔ اسناد انتخابشده و بیان شباهتها و تفاوتها، با ذکر منبع |
| /translate | ترجمهٔ متن به زبان رابط |
| /outline | فهرست نکتههای کلیدی، با ذکر منبع |
| /strict | رفتن به شیوهٔ «فقط بر اساس اسناد» |
| /hybrid | رفتن به شیوهٔ «اسناد و دانش مدل» |
| /free | رفتن به «گفتوگوی آزاد» |
| /documents | بازکردن پنل اسناد |
| /help | نمایش راهنمای برنامه |
نقطهٔ شروع
هنگام پردازش
مرحلههای واقعی پردازش بهترتیب نمایش داده میشوند: «درک پرسش و زمینهٔ گفتوگو»، «یافتن شواهد مرتبط در اسناد» و «نگارش پاسخ نهایی». بعد، پاسخ کلمهبهکلمه روی صفحه میآید. هر پرامپت زبان پاسخ را از روی پرسش شما مشخص میکند؛ پس پرسش انگلیسی در حالت «ترکیبی» و «گفتوگوی آزاد» هم پاسخ انگلیسی میگیرد.
خواندن پاسخ
هر پاسخ نشان میدهد محتوایش از کجا آمده است و میتوانید هر منبع را باز کنید.
باز کردن در صفحهٔ جداارجاعها و منابع
- مدل با [n] به بخشها ارجاع میدهد و رابط این ارجاعها را به برچسبهای شمارهداری تبدیل میکند که همان بخش را باز میکنند.
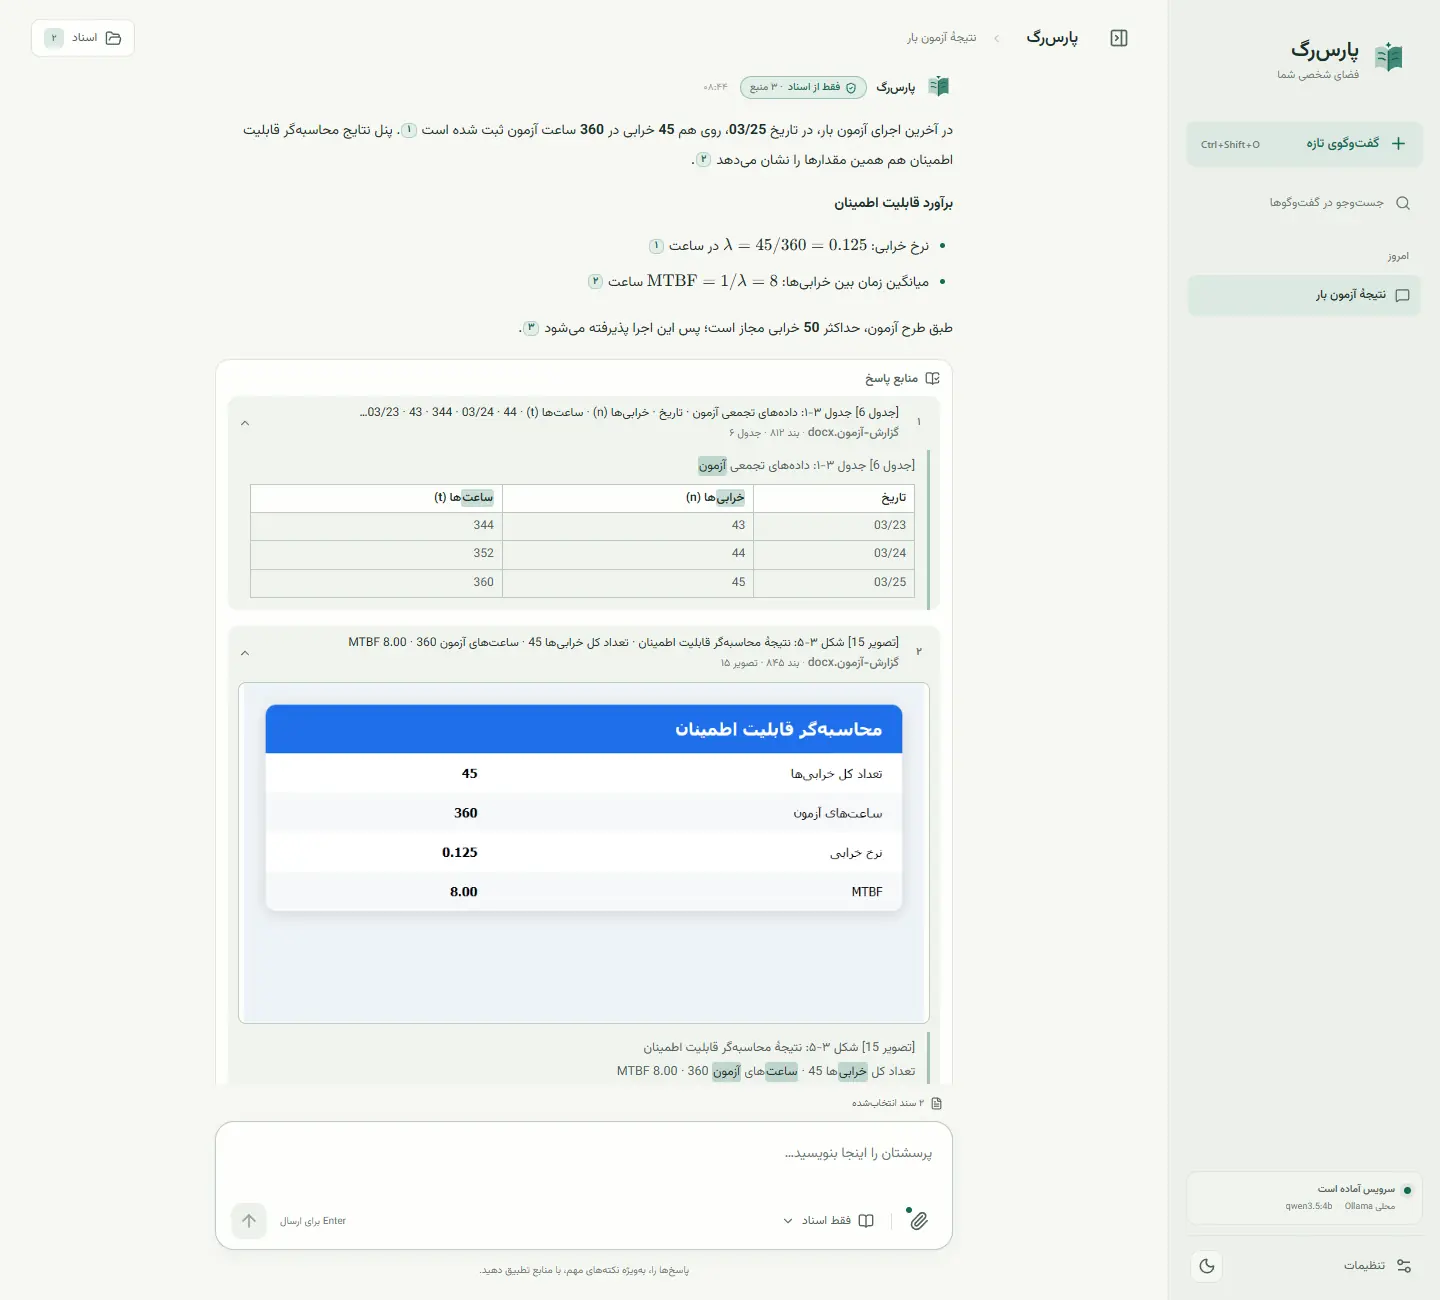
- فهرست «منابع پاسخ» هر بخش ارجاعشده را با پیشنمایشی کوتاه، نام فایل و جای آن در فایل نشان میدهد، مثل «بند ۸۱۲ · جدول ۶» یا «بند ۸۴۵ · تصویر ۱۵». در حالت باز، تا ۱٬۶۰۰ نویسه از متن دیده میشود و واژههای پرسش در آن برجستهاند.
- بخشهای جدولی به شکل جدول نمایش داده میشوند و بخشی که از یک تصویر خوانده شده، خود تصویر را هم کنار متن نشان میدهد.
- بخشهایی که بررسی شدهاند ولی ارجاعی نگرفتهاند، زیر «بخشهای دیگری هم بررسی شد» جمع میشوند.
پاسخ از کجا آمده است
| برچسب | زمان نمایش |
|---|---|
| فقط از اسناد | پاسخ در شیوهٔ «فقط اسناد» |
| اسناد و دانش مدل | پاسخ در شیوهٔ «ترکیبی» |
| دانش عمومی مدل | پاسخ در «گفتوگوی آزاد» |
| در اسناد پیدا نشد | پاسخی در اسناد نبود |
وقتی پاسخی پیدا نمیشود
| نتیجه | پیام |
|---|---|
| بخش مرتبطی پیدا نشد | در اسناد این گفتوگو بخش مرتبطی پیدا نشد. سندی را اضافه کنید یا پرسش را دقیقتر بنویسید. |
| شاهدی پیدا نشد | بر اساس اسناد ارائهشده، پاسخی برای این پرسش در متن پیدا نشد. اگر میخواهید از دانش عمومی مدل هم کمک گرفته شود، حالت «ترکیبی» را انتخاب کنید. |
| شواهد ناقص | برای همهٔ سندهایی که نام بردید شواهد کافی پیدا نشد. پرسش را برای هر سند جدا بپرسید یا نام سند را بررسی کنید. |
کار با پاسخ
- دکمههای «کپی پاسخ»، «تلاش دوباره»، «کپی پیام» و «ویرایش پیام». تلاش دوباره یا ویرایش، نسخهٔ تازهای از پاسخ میسازد و میتوانید بین نسخهها جابهجا شوید. ویرایش پیام شاخهٔ تازهای باز میکند که ادامهٔ خودش را دارد.
- فرمولها با KaTeX نمایش داده میشوند. واژههای فارسی هرگز به شکل فرمول چیده نمیشوند، جداکنندههایی که بسته نشدهاند حذف میشوند و نشانهگذاری ریاضیای که بعضی مدلهای Gemini وارد پاسخ میکنند، به شکل فرمول نمایش داده میشود.
- تصویرهای خارجی درون پاسخ بارگیری نمیشوند.
- خطاها بر اساس کدشان توضیح داده میشوند؛ مثلاً PDF رمزدار، کلید API ردشده، مدلی که نصب نیست یا حساب APIای که اعتبارش تمام شده است.
حریم خصوصی و امنیت
پارسرگ برای یک نفر روی یک رایانه طراحی شده است. اسناد، ایندکس و گفتوگوها را محلی نگه میدارد و هر چیزی که ممکن است بیرون برود، فقط با انتخاب صریح شما بیرون میرود.
باز کردن در صفحهٔ جداآنچه سرویس هرگز ذخیره نمیکند
- فایلهای بارگذاریشده: فقط در زمان پردازش، در حافظه و یک پوشهٔ موقت روی RAM هستند. آنچه میماند متن استخراجشده، بردارهای آن و نسخهٔ کوچکی از هر تصویر خواندهشده با OCR است که همه در Qdrant نگه داشته میشوند. با SOURCE_IMAGE_PREVIEWS=0 تصویرها نگه داشته نمیشوند.
- پرسشها و بخشهای بازیابیشده: در لاگ ثبت نمیشوند.
- گفتوگوها: در IndexedDB مرورگر خودتان ذخیره میشوند، نه روی سرور.
- کلیدهای API: فقط در حافظهٔ فرایند یا متغیرهای محیطی.
محافظتهای شبکه
- فقط درخواستهایی پذیرفته میشوند که مقصدشان localhost، 127.0.0.1 یا ::1 باشد؛ همین جلوی حملهٔ DNS rebinding را میگیرد. با PARSRAG_ALLOWED_HOSTS میتوانید نامهای دیگری را برای استفاده در شبکهٔ محلی اضافه کنید.
- درخواستهایی که داده را تغییر میدهند باید از نشانی خود برنامه یا از یک مبدأ مجاز بیایند.
- نشانی Ollama به loopback، سرویس ollama، host.docker.internal و میزبانهای فهرست OLLAMA_ALLOWED_HOSTS محدود است و مرورگر نمیتواند این فهرست را گسترش دهد.
- تنظیماتی که در برنامه تغییر میدهید به چیزهایی که از مرز اعتماد محافظت میکنند دست نمیزنند: پورتها، میزبانها و مبدأهای مجاز، OLLAMA_ALLOWED_HOSTS، سقف درخواست، سقف حافظه و دانلود مدل.
- برنامه بهطور پیشفرض روی 127.0.0.1 گوش میدهد و Qdrant روی شبکهای داخلی و بدون دسترسی بیرونی است.
ایمنسازی کانتینر
- سیستم فایل فقطخواندنی، پوشهٔ /tmp روی RAM، بدون امکان گرفتن امتیاز تازه و با حذف همهٔ capabilityهای لینوکس.
- برنامه با کاربری غیر از root اجرا میشود و pip از image نهایی حذف شده است.
- سقف حافظه بهطور پیشفرض: ۶ گیگابایت برای برنامه، ۲ گیگابایت برای Qdrant و ۱۲ گیگابایت برای Ollama داخل Docker.
اگر میخواهید پارسرگ را روی شبکهٔ مشترک یا نامطمئن بگذارید، به یک reverse proxy با احراز هویت نیاز دارید. خود Ollama هم احراز هویت ندارد؛ پس Ollamaی رایانه را روی شبکهٔ عمومی باز نگذارید. آسیبپذیریها را بهصورت خصوصی و از زبانهٔ Security مخزن در گیتهاب گزارش کنید.
فضای کار شما
رابط پارسرگ یک فضای کار کامل است، با گفتوگوها، تنظیمات، پوستهها و دو زبان، و میتوان آن را مانند یک برنامه نصب کرد.
باز کردن در صفحهٔ جداگفتوگوها
- تاریخچه در سه گروه «امروز»، «دیروز» و «پیشتر» مرتب میشود و جستوجو هم در عنوانها میگردد و هم در متن پیامها.
- هر گفتوگو را میتوانید تغییر نام دهید، بهصورت فایل Markdown دریافت کنید یا حذف کنید.
- از همهٔ گفتوگوها و ترجیحات، یک فایل پشتیبان JSON بگیرید و روی رایانهٔ دیگری بازیابی کنید. اسناد باید آنجا دوباره بارگذاری شوند.
- گزینهٔ «پاککردن همهٔ دادهها» همهٔ گفتوگوها و اسناد ایندکسشده را حذف میکند. اگر سرویس نتواند حذف را تأیید کند، دادههای مرورگر نگه داشته میشوند.
تنظیمات
- چهار زبانه: «ظاهر و زبان»، «پاسخگویی»، «مدل و اتصال» و «اسناد و سرعت».
- تغییر تنظیمات مدل، بازیابی، بارگذاری، OCR و سرعت ایندکس در حین اجرای پارسرگ و بدون راهاندازی دوباره اعمال میشود. کنار هر تنظیم مقدار .env آن آمده و میتوان به آن برگشت.
ظاهر و زبان
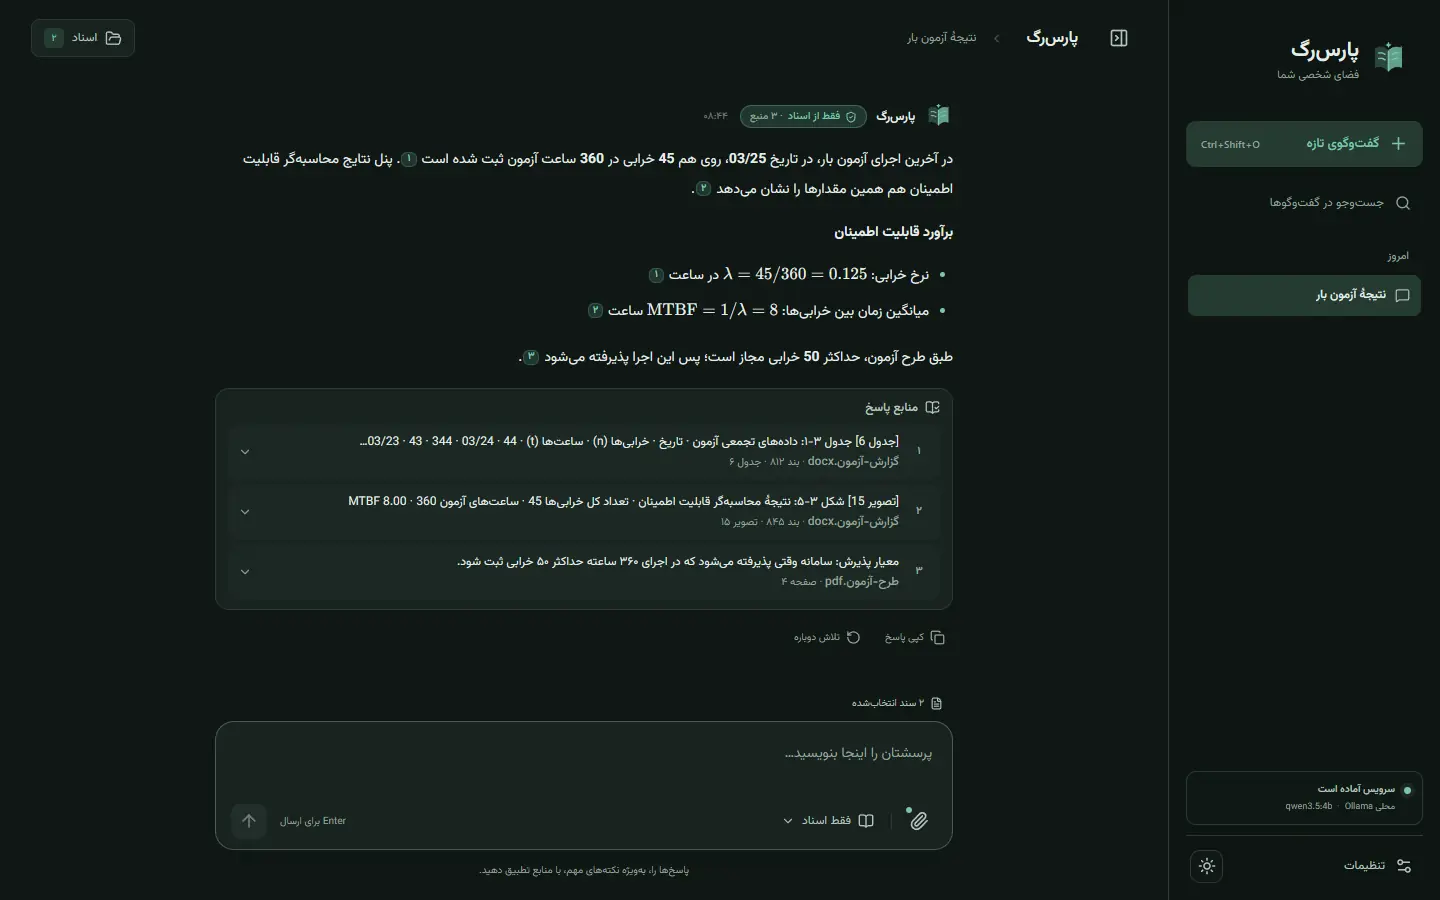
- پوستهٔ روشن و تیره؛ جابهجایی بین آنها با یک جلوهٔ دایرهای از همان نقطهای که کلیک کردهاید انجام میشود.
- چهار رنگبندی: «سبز پارسرگ»، «آبی اقیانوس»، «نیلی آرام» و «خاکی گرم».
- زبان پیشفرض فارسی است. با تغییر زبان، کل چیدمان بین راستبهچپ و چپبهراست عوض میشود و جهت هر پاسخ از زبان خود آن پاسخ پیروی میکند.
- در صفحههای باریک، فهرست گفتوگوها به پنلی تبدیل میشود که هر وقت لازم بود بازش میکنید.
میانبرهای صفحهکلید
| کار | ویندوز / لینوکس | مک |
|---|---|---|
| گفتوگوی تازه | Ctrl+Shift+O | ⌘⇧O |
| جستوجوی گفتوگوها | Ctrl+Shift+K | ⌘⇧K |
| بازکردن اسناد | Ctrl+Shift+D | ⌘⇧D |
| بازکردن تنظیمات | Ctrl+, | ⌘, |
| رفتن به کادر پیام | / | / |
| نمایش راهنما | Ctrl+Shift+H | ⌘⇧H |
| تغییر حالت روشن و تیره | Ctrl+Shift+Y | ⌘⇧Y |
راهنمای گامبهگام و نصب برنامه
- در نخستین بازدید، راهنمایی ۳۳ مرحلهای باز میشود که همهٔ کنترلها را در جای خودشان معرفی میکند و هیچوقت تنظیمات یا دادههایتان را تغییر نمیدهد. هر وقت خواستید، میتوانید از «تنظیمات ← ظاهر و زبان ← راهنمای فضای کار» دوباره آن را ببینید.
- پارسرگ را میتوانید بهصورت برنامه نصب کنید. رابط بدون اینترنت هم باز میشود، ولی برای گرفتن پاسخ همچنان به سرویس نیاز است. درخواستهای مدل و دادههای اسناد هرگز کش نمیشوند.
- اگر هنگام نمایش صفحه خطایی رخ دهد، بهجای صفحهٔ سفید یک صفحهٔ بازیابی میآید و دادههایتان ذخیرهشده باقی میمانند.
معماری
بکاند با الگوی پورت و آداپتور سازماندهی شده است: هسته فقط رابطها (interface) را میشناسد و یک ریشهٔ ترکیب (composition root) آنها را به Qdrant، تجزیهگرها، OCR و کلاینتهای مدل وصل میکند.
باز کردن در صفحهٔ جدا| لایه | چه چیزی در آن است |
|---|---|
| دامنه | اسناد، قسمتها، شیوههای پرسش، سیاست بارگذاری، تنظیمات زمان اجرا، خطاها |
| اشیای انتقال داده (DTO) | درخواستهای اعتبارسنجیشده و پاسخهای نوعدار |
| پورتها | مخزن داده، تجزیهگر، بخشبند، خلاصهگر پرسش، دروازهٔ مدل، گزارش پیشرفت، رتبهبند، انبارهٔ تنظیمات زمان اجرا |
| یوزکیسها | برای هر عملیات یک کلاس: دریافت و ایندکس سند، پاسخ، پیشنهاد پرسش، استفادهٔ دوباره، حذف، تنظیم مدل، فهرست مدلهای Ollama، تغییر تنظیمات زمان اجرا، نمایش تصویر ارجاعشده و… |
| راهبردها | مسیرهای «فقط اسناد»، «ترکیبی» و «گفتوگوی آزاد»؛ ارجاعها؛ بودجهٔ زمینه؛ یکسانسازی فارسی |
| آداپتورها | پایگاه برداری Qdrant و ایندکس BM25، کلاینتهای مدل LlamaIndex، رتبهبند FlashRank، تجزیهگرهای PDF، Office و OCR |
| لایهٔ API | مسیرهای FastAPI، میانافزارها، نگاشت خطاها و رویدادهای جریانی (Server-Sent Events) |
در Compose سه کانتینر تعریف شده است: برنامه، Qdrant و Ollama که فقط با پروفایل local-model اجرا میشود. برنامه میتواند بهجای کانتینر Ollama از Ollamaی نصبشده روی میزبان استفاده کند که از راه host.docker.internal در دسترس است؛ در این حالت مدلها و GPU میزبان مستقیم به کار میروند. خطاها با کدهای ollama_url_not_allowed یا ollama_unreachable گزارش میشوند.
رابط HTTP
| مسیر | کاربرد |
|---|---|
| GET /health/live, /health/ready | بررسی زندهبودن سرویس، و آمادگی آن وقتی مدلها و Qdrant در دسترساند |
| GET /capabilities | محدودیتهای بارگذاری و نوع فایلهای پشتیبانیشده |
| GET, PUT /models/configuration | خواندن اتصال مدل، یا بررسی و اعمال آن |
| GET /models/ollama | مدلهای نصبشدهٔ Ollama |
| GET, PUT, DELETE /settings/runtime | خواندن، تغییر یا بازگرداندن تنظیماتی که در برنامه تغییر کردهاند |
| POST /ingest | بارگذاری و ایندکس فایلها |
| POST /query, /query/stream | پاسخ به پرسش، یکجا یا جریانی |
| POST /sessions/{id}/suggestions | سه پرسشی که اسناد جوابشان را دارند |
| POST /sessions/{id}/files/reuse | کپی سند ایندکسشده از گفتوگوی دیگر |
| GET /sessions/{id}/images/{n} | تصویری که بخش ارجاعشده از آن خوانده شده |
| GET, DELETE /sessions/{id}/files | فهرست یا حذف اسناد یک گفتوگو |
| DELETE /sessions/{id} | حذف ایندکس یک گفتوگو |
پاسخ جریانی
مسیر POST /query/stream رویدادها را به این ترتیب میفرستد: stage (درک، بازیابی، نگارش)، sources، یک token برای هر تکه از متن، و در پایان done همراه با پاسخ کامل، نتیجهٔ آن و شمارهٔ بخشهای ارجاعشده. خطاها به شکل رویداد error با یک کد ثابت میرسند.
هر پاسخ خطا، کنار پیامش یک کد ثابت دارد تا رابط بتواند خطا را به زبان شما توضیح دهد.
کیفیت و انتشار
همهٔ تغییرها از بررسیهای یکسانی میگذرند که نتیجهشان عمومی است، و هر نسخه پیش از انتشار وارسی میشود.
باز کردن در صفحهٔ جدادر هر تغییر
- بکاند: قالببندی و lint با Ruff، بررسی سختگیرانهٔ نوعها با mypy و آزمونهای pytest با پوشش شاخهای دستکم ۸۵ درصد.
- فرانتاند: بازبینی امنیتی وابستگیها، آزمونهای واحد، build همراه با بررسی نوعها، و آزمونهای مرورگر و نصب برنامه با Playwright.
- هر دو روی لینوکس، ویندوز و مک اجرا میشوند.
- آزمون سرتاسری: تجزیهٔ واقعی فایل، embedding، Qdrant، رتبهبندی و پاسخ جریانی، با یک مدل جایگزین. دستکم در ۷ پرسش از ۸ پرسش فارسیِ بازنویسیشده، اولین ارجاع باید به قسمت مربوط به همان پرسش باشد.
- روی رایانهٔ خودتان، همهٔ آزمونهای بکاند بدون ردشدن هیچ آزمونی و بدون Docker اجرا میشوند: با PARSRAG_E2E=1 آزمونهای سرتاسری روی یک Qdrant درونحافظهای اجرا میشوند، مگر اینکه QDRANT_HOST به یک سرور اشاره کند.
- بستهبندی: image داکر ساخته میشود و import برنامه درون آن آزمایش میشود.
زنجیرهٔ تأمین
- بازبینی وابستگیها در Pull Requestها و بررسی آسیبپذیری بستههای Python.
- فهرست اجزای نرمافزار (SBOM) ساخته و image اسکن میشود. یافتههای پرخطر یا بحرانی که راهحل دارند، build را متوقف میکنند.
- ابزار Dependabot هر هفته بهروزرسانی وابستگیها را پیشنهاد میکند.
بهبودهای اندازهگیریشده در نسخهٔ 1.0
بهبودهای اندازهگیریشده در نسخهٔ 1.1
- پرسشهای چندبخشی: ۵ پاسخ از ۶ پاسخی که بخشی از پرسش را جا انداخته بودند کامل شدند و هیچ پرسشی بدتر نشد.
- خواندن همزمان تصویرها: گزارشی با ۹۶ تصویر بهجای ۱۲۱ ثانیه در ۳۳ ثانیه پردازش شد و متن بهدستآمده تغییری نکرد. ایندکس کل همان گزارش از حدود ۴٫۵ دقیقه به حدود ۳ دقیقه رسید.
- خواندن اسکرینشاتها با OCR: تعداد واقعیتهای خواندهشده از ۳۳ به ۳۷ از ۴۰ رسید، به بهای حدود یکسوم زمان بیشتر برای هر تصویر.
- مدلهای فکرکننده: روی GPU ششگیگابایتی با qwen3.5:4b، بهجای پاسخ خالی پس از ۵۹ ثانیه، پاسخی با ارجاع در ۷ ثانیه به دست آمد.
این اندازهگیریها روی مجموعهسندهایی انجام شده که منتشر نشدهاند. بنابراین از روی مخزن عمومی نمیتوان آنها را بازتولید کرد.
مرجع پیکربندی
تنظیمات، متغیرهای محیطی فایل .env هستند و ۲۷ مورد از آنها را بدون راهاندازی دوباره از بخش تنظیمات خود برنامه هم میتوانید تغییر دهید. اینها متغیرهاییاند که به احتمال زیاد تغییرشان میدهید. مقدارهای پیشفرض، همان مقدارهای Docker هستند.
باز کردن در صفحهٔ جدادر خود برنامه
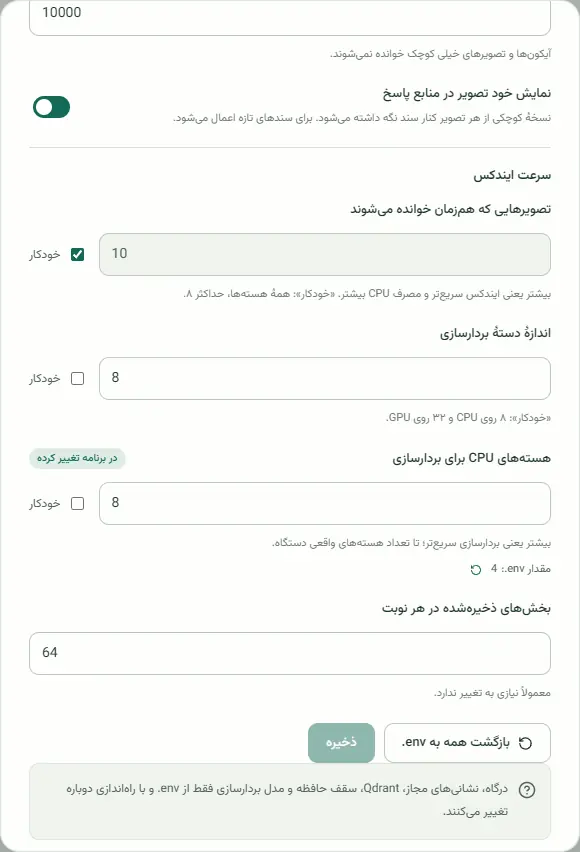
- بخش تنظیمات ۲۷ گزینه را در چهار گروه تغییر میدهد: مدل (اندازهٔ زمینه، «فکر کردن»، تلاش دوباره و مهلتها)، بازیابی (آستانه، عمق جستوجو و جستوجوی کلیدواژهای)، اسناد (سقف بارگذاری، OCR و نمایش تصویر) و سرعت ایندکس (تصویرهای همزمان، رشتههای CPU و اندازهٔ دستهها).
- کنار هر گزینه مقدار .env آن آمده و میتوانید یکییکی یا با دکمهٔ «بازگشت همه به .env» به آن برگردید. مقدارهایی که در برنامه ذخیره میشوند بر .env مقدماند، پس از راهاندازی دوباره هم میمانند و در volume به نام app_config نگه داشته میشوند.
- پورت، نشانیهای مجاز، Qdrant، سقف حافظه، بزرگترین درخواست بارگذاری و مدل بردارسازی فقط در .env تغییر میکنند و پس از راهاندازی دوباره اعمال میشوند.
- در فایل .env.example فقط انتخاب مدل فعال است. بقیهٔ سطرها مقدار پیشفرض را نشان میدهند و بر این اساس گروهبندی شدهاند که از تنظیمات برنامه هم تغییر میکنند یا نه.
مدل
| متغیر | پیشفرض | کاربرد | در برنامه |
|---|---|---|---|
| LLM_PROVIDER | ollama | مقدار ollama یا api | مدل و اتصال |
| LLM_MODEL_NAME | در .env.example: qwen2.5:7b | مدلی که پاسخ را مینویسد | مدل و اتصال |
| OLLAMA_DOCKER_BASE_URL | در .env.example: http://host.docker.internal:11434 | نشانی Ollama از دید کانتینر برنامه؛ برای Ollama داخل Docker، http://ollama:11434 | مدل و اتصال |
| MODEL_API_BASE_URL | https://openrouter.ai/api/v1 | نشانی سرویس سازگار با OpenAI | مدل و اتصال |
| MODEL_API_KEY | خالی | کلید محرمانهٔ زمان اجرا؛ هرگز روی دیسک نوشته نمیشود | مدل و اتصال |
| MODEL_API_DISCLOSURE_ACKNOWLEDGED | 0 | رضایت برای استفاده از API خارجی | مدل و اتصال |
| OLLAMA_CONTEXT_LENGTH | 8192 | اندازهٔ زمینهای که Ollama برای هر پرسش کنار میگذارد | مدل و اتصال |
| OLLAMA_THINK | 0 | اجازهٔ «فکر کردن» پیش از پاسخ، برای مدلهای فکرکننده | مدل و اتصال |
| MODEL_CONTEXT_WINDOW | 32768 | اندازهٔ زمینهٔ فرضی برای مدلهای API | مدل و اتصال |
| MODEL_API_MAX_RETRIES | 4 | تعداد تلاش دوباره برای خطاهای HTTP 5xx و 429 | مدل و اتصال |
| LLM_REQUEST_TIMEOUT_SECONDS | 120 | مهلت هر پاسخ | مدل و اتصال |
| OLLAMA_ALLOWED_HOSTS | خالی | میزبانهای دیگری که نشانی Ollama میتواند داشته باشد | فقط .env |
جستوجو
| متغیر | پیشفرض | کاربرد | در برنامه |
|---|---|---|---|
| STRICT_RAG_THRESHOLD | 0.75 | آستانهٔ دروازهٔ شواهد در «فقط اسناد» | پاسخگویی |
| STRICT_RAG_TOP_K | خالی | عمق ثابت جستوجو در «فقط اسناد» بین ۱ تا ۵۰؛ خالی یعنی انتخاب جداگانه برای هر پرسش | پاسخگویی |
| HYBRID_RETRIEVE_TOP_K | 25 | تعداد نامزدهای اولیه در حالت ترکیبی | پاسخگویی |
| KEYWORD_SEARCH | 1 | ترکیب BM25 با جستوجوی برداری | پاسخگویی |
| EMBED_MODEL_NAME | intfloat/multilingual-e5-base | مدل embedding؛ با تغییرش باید اسناد را دوباره بارگذاری کنید | فقط .env |
| EMBED_DEVICE | auto | یکی از auto، cpu، cuda یا mps | فقط .env |
| RERANK_MODEL | miniReranker_arabic_v1 | رتبهبند حالت ترکیبی؛ مقدار none آن را خاموش میکند | فقط .env |
اسناد و OCR
| متغیر | پیشفرض | کاربرد | در برنامه |
|---|---|---|---|
| PARSRAG_MAX_FILES_PER_SESSION | 10 | تعداد فایل در هر گفتوگو | اسناد و سرعت |
| PARSRAG_MAX_FILE_BYTES | 104857600 | ۱۰۰ مبیبایت برای هر فایل | اسناد و سرعت |
| PARSRAG_MAX_BATCH_BYTES | 524288000 | ۵۰۰ مبیبایت برای هر بارگذاری | اسناد و سرعت |
| OCR_ENABLED | 1 | روشن یا خاموشکردن OCR | اسناد و سرعت |
| OCR_LANGUAGES | fas+eng | زبانهای Tesseract | اسناد و سرعت |
| OCR_DPI | 200 | وضوح رندر صفحههای اسکنشده | اسناد و سرعت |
| OCR_MAX_PAGES | 30 | تعداد صفحههای اسکنشدهای که از هر فایل خوانده میشود | اسناد و سرعت |
| OCR_MAX_IMAGES | 200 | تعداد تصویرهایی که از هر فایل Word یا PowerPoint خوانده میشود | اسناد و سرعت |
| SOURCE_IMAGE_PREVIEWS | 1 | نگهداشتن نسخهای از هر تصویر برای نمایش کنار منبعش | اسناد و سرعت |
| PARSRAG_MAX_REQUEST_BYTES | 534773760 | بزرگترین درخواست بارگذاری؛ سقفهای بالا از آن بیشتر نمیشوند | فقط .env |
سرعت ایندکس
| متغیر | پیشفرض | کاربرد | در برنامه |
|---|---|---|---|
| OCR_WORKERS | خالی | تعداد تصویرهایی که همزمان خوانده میشوند؛ خالی یعنی همهٔ هستههای CPU، حداکثر ۸ | اسناد و سرعت |
| PARSRAG_CPU_THREADS | 4 | رشتههای CPU برای بردارسازی، تا تعداد هستههای واقعی | اسناد و سرعت |
| EMBED_BATCH_SIZE | 8 | تعداد متن در هر دور بردارسازی؛ با فایل GPU برابر ۳۲ | اسناد و سرعت |
| QDRANT_UPSERT_BATCH_SIZE | 64 | تعداد بخشهایی که در هر نوبت ذخیره میشوند | اسناد و سرعت |
سرویس و حافظه
| متغیر | پیشفرض | کاربرد | در برنامه |
|---|---|---|---|
| PARSRAG_PORT | 8000 | پورت روی رایانهٔ شما | فقط .env |
| PARSRAG_BIND_HOST | 127.0.0.1 | نشانیای که پورت روی آن باز میشود | فقط .env |
| PARSRAG_ALLOWED_HOSTS | خالی | نامهای میزبانی که جز localhost، 127.0.0.1 و ::1 پذیرفته میشوند | فقط .env |
| PARSRAG_APP_MEMORY_LIMIT | 6g | سقف حافظهٔ کانتینر برنامه | فقط .env |
| QDRANT_MEMORY_LIMIT | 2g | سقف حافظهٔ Qdrant | فقط .env |
| OLLAMA_MEMORY_LIMIT | 12g | سقف حافظهٔ کانتینر Ollama | فقط .env |
مجوز و ارجاع
کد منبع پارسرگ در دسترس است، اما پارسرگ متنباز نیست. میتوانید کد را بخوانید و نسخههای رسمی را اجرا کنید، اما برای تغییر یا بازنشر آن باید اجازه بگیرید.
باز کردن در صفحهٔ جدامجاز است
- دانلود و کپی یک نسخهٔ رسمی و تغییرنیافته.
- نصب و اجرای آن برای استفادهٔ شخصی، دانشگاهی، پژوهشی، آموزشی یا درونسازمانی.
- خواندن و مطالعهٔ کد منبع.
- آمادهکردن تغییر، فقط برای ارسال آن به مخزن رسمی.
بدون اجازهٔ کتبی مجاز نیست
- تغییر یا ساخت اثر مشتق، جز برای آمادهکردن مشارکت.
- انتشار، بازتوزیع، فروش یا اجاره، یا ارائه به دیگران بهشکل سرویس میزبانیشده یا مدیریتشده.
- تغییر برند، یا استفاده از نام و نشان پارسرگ جز برای معرفی یک نسخهٔ رسمی.
ارجاع به پارسرگ
نوشتهها و پژوهشهایی که از پارسرگ استفاده میکنند باید به آن ارجاع دهند. متن ارجاع در قالبهای APA و BibTeX از فایل CITATION.cff مخزن ساخته میشود.